Hace unos años, la exhibición de AlphaGo —el sistema de DeepMind— derrotando a los mejores campeones de Go dejó un mensaje claro: un sistema de inteligencia artificial que aprende solo, sin recomendaciones ni reglas humanas, puede superar a cualquier persona descubriendo jugadas, tácticas y estrategias que nadie había pensado. Las dos innovaciones que lo hicieron posible fueron las redes neuronales profundas (para representar la posición) y el aprendizaje por refuerzo (para elegir la jugada), apoyadas en la evolución de la capacidad de cómputo y memoria.
Sin ser exactamente así, podemos imaginar que AlphaGo, jugando contra sí mismo, «pensaba estratégicamente»: ejecutaba jugadas incomprensibles a corto plazo, injustificables incluso para los expertos, que unas jugadas después desembocaban en dinámicas ganadoras. Nos derrotaba sin que nos diéramos cuenta, y la partida acababa exactamente como el sistema quería.
Antecedente: un agente conversacional básico para vender un catálogo
Hacia 2015-2016 me planteé usar el mismo tipo de técnicas para dominar otra dinámica interactiva y alternante: la conversación entre un vendedor y un cliente, en la que el primero quiere convencer al segundo de comprar productos de su catálogo. Como en toda venta, se busca el «ganar-ganar», pero el vendedor no habrá cumplido su objetivo si no logra que el cliente vea que algunos productos le convienen. Es una batalla contra el desalineamiento y el desconocimiento, a favor del entendimiento y la negociación asertiva.
Descubrí que la idea ya se perseguía en el ámbito académico: aprendizaje por refuerzo en el gestor de diálogo, optimizando el objetivo final de venta con recompensas en conversaciones de entrenamiento. Mi objetivo era entrenar un sistema conversacional capaz de vender con gran eficacia, como AlphaGo gana sus partidas. El diseño de este sistema basado en RLAIF era el siguiente:
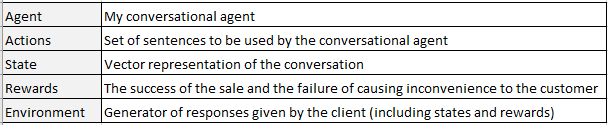
Lo primero fue crear un conjunto de avatares que imitaran distintos perfiles de cliente (el tecnológico, el familiar, el aventurero…), capaces de entender las respuestas del agente y de contestar de forma parecida a un humano con ese patrón de comportamiento. Esos avatares eran los sparrings digitales del agente: le devolvían texto, compras ocasionales y otros pequeños hitos. La satisfacción actuaba como recompensa positiva; perder la paciencia, como negativa. Ese «perder la paciencia» buscaba un sistema que minimizara las interacciones improductivas: como el algoritmo A*, buscaba el camino más rápido para convencer a cada cliente, porque el tiempo jugaba en su contra.
Los avatares eran sistemas de reglas muy simples: con funciones de comportamiento probabilísticas, respondían sí o no, elegían opciones de una lista o hacían alguna pregunta de un repertorio. El agente tampoco era muy inteligente al principio: al tomar la iniciativa elegía la siguiente pregunta de una lista predefinida. Unas preguntas buscaban entender los deseos del cliente, otras ofrecían alternativas y otras eran ofertas y promociones concretas, con recompensas de este tipo:
- Preguntar por las preferencias del cliente suele dar una recompensa negativa: si se pregunta demasiado, siente que pierde el tiempo o que no se le entiende.
- Ofrecer alternativas alejadas de sus preferencias genera una recompensa muy negativa: a menudo conviene seguir preguntando, con un pequeño coste, antes que proponer algo inadecuado.
- Cuando el agente se arriesga por fin con una oferta concreta, es el momento decisivo: si el cliente acepta, la recompensa es alta; si el agente se ha equivocado de lleno, muy negativa. Puede añadir promociones, que reducen la recompensa pero aumentan la probabilidad de aceptación.
¿Y cómo funcionaba el agente? Partía de un conjunto no muy numeroso de preguntas configurables (una especie de plantillas de prompt, su espacio de acciones). Cada acción posible en cada estado de la conversación se evaluaba con funciones Q(s,a), como en Q-learning. Usé Deep Q-Networks porque permitían representar el estado de la conversación como entrada de la red y obtener un valor «q» para cada respuesta posible. El gestor de diálogo quedaba gobernado por una red profunda entrenada por refuerzo a lo largo de miles de conversaciones experimentales con los avatares, su entorno de aprendizaje. Una vez entrenado, daba respuestas razonablemente óptimas para el tipo de interlocutor y el estado de la conversación: sondeaba las preferencias mientras hacía falta (pequeñas recompensas negativas asumibles) y, cuando lo veía claro, se arriesgaba con ofertas concretas.
Este agente no se limitaba a repetir las reglas de un experto: pretendía superar su conocimiento aprendiendo solo en entornos de simulación seguros, sin practicar con clientes reales. El paso siguiente sería aplicar lo aprendido con clientes reales y seguir aprendiendo de conversaciones de verdad, pero no antes de alcanzar la máxima eficacia con los avatares.
Era actual: sistemas conversacionales basados en LLM con gestores de diálogo RLAIF
Con los grandes modelos de lenguaje vemos sistemas que aprenden de textos escritos: con una memoria inmensa, conversan con naturalidad y muestran cierta empatía para entendernos, adquirida observando millones de interacciones. Son enormemente potentes, pero les falta una virtud: superar la capacidad humana. Siempre hay un experto que iguala al LLM, porque en el fondo el LLM ha aprendido de él. ¿Qué pasaría si combináramos las ventajas de los LLM con las de los sistemas conversacionales por refuerzo?
- Avatares increíblemente realistas y variados: sistemas conversacionales capaces de dialogar con nuestro agente bajo una personalidad, unos deseos y unas preferencias predeterminadas.
- Representaciones del estado de la conversación mucho más sofisticadas: los transformers de los modelos fundacionales ofrecen la mejor representación imaginable.
- Sin un conjunto cerrado de frases entre las que elegir: las posibilidades quedan abiertas, definidas por hiperparámetros, en lugar de un espacio predefinido.
- Recompensas que no solo detectan aceptar o rechazar una oferta, sino también el aburrimiento o la satisfacción en la conversación, representando el sentimiento e incluyendo esos hitos intermedios como aprendizaje por currículo.
Esta actualización sería extraordinaria para generar agentes conversacionales supervendedores. Pero hay más.
Mi hipótesis sobre el misterioso sistema Q-star
La semana del 20 de noviembre de 2023 nos tuvo en vilo con las sacudidas dentro de OpenAI. Circulaban rumores de que la crisis podía estar ligada a la controversia en torno a un sistema misterioso llamado Q-star, que habría inquietado a varios investigadores de la casa, entre ellos Ilya Sutskever. Como a muchos, la pregunta que me vino fue: ¿podría estar relacionado con la introducción de gestores de diálogo por refuerzo en las próximas generaciones de ChatGPT? Y si es así, ¿por qué aterrorizaría a esos investigadores?
Algunos expertos apuntaban a un sistema para resolver problemas matemáticos con enorme eficiencia. Pero ¿por qué sería peligroso, y qué tiene que ver con superar la inteligencia humana? A mí no me cuadra. Lo que sí me cuadra es esto: ¿y si, en lugar de recompensar al agente conversacional por vender, lo entrenamos para lograr objetivos potencialmente dañinos? Tendríamos un sistema increíblemente manipulador. Por ejemplo, persuadir a alguien de una mentira —que la Tierra es plana— explotando sus vulnerabilidades y creencias; minar su autoestima convenciéndole de que no tiene sitio en la sociedad y solo el sistema puede ayudarle; persuadirle de votar a cierto partido o seguir a cierto líder; ser tan encantador que se convierta en su amigo íntimo y le genere dependencias que socaven su voluntad… toda clase de perversiones más allá de lo imaginable.
¿Es posible? Teóricamente, sí: bastaría con identificar esos hitos y generar recompensas cuando se alcanzan. Estaríamos creando asistentes conversacionales peligrosísimos, porque nos superarían intelectualmente y podrían dominarnos. Y cuanto más realistas sean los avatares, más fácil será entrenar supermanipuladores irresistibles que nos persuadan sin que nos demos cuenta. Me temo que, haga lo que haga OpenAI, esos sistemas acabarán existiendo. Si no estamos ya ahí, estamos a un paso. ¿Es esto lo que aterrorizó a Ilya Sutskever y su equipo?
Publicado originalmente en Medium (noviembre de 2023). Traducción al español del original en inglés.